
Les grands modèles de langage généralistes (ChatGPT, Claude, Gemini) ne sont pas neutres épistémiquement. Leur mécanisme d’apprentissage produit un biais structurel, pas nécessairement corrigé par le système d’IA dans lequel ils sont plongés, et dont l’intensité varie selon les disciplines : très faible en mathématiques, très fort dans les sciences sociales et humaines. Cet article propose une grille d’analyse fondée sur trois critères — densité du signal de vérité, résistance sociologique du paradigme dominant, séparabilité fait/valeur — appliquée à une classification en cinq catégories épistémologiques. Plusieurs disciplines décisives pour la transition écologique font partie des domaines où le biais paradigmatique peut être le plus élevé. Cette analyse conduit à faire des recommandations pour les utilisateurs de ces modèles, pour leur gouvernance, pour l’architecture des systèmes d’information scientifique et pour la recherche en IA.
Dans cet article, qui prolonge une tribune que j’ai publiée cet été, le biais paradigmatique désigne la tendance d’un modèle à privilégier, dans ses réponses, les cadres théoriques, méthodes, institutions, langues et controverses les plus représentés ou légitimés par ses données, son post-entraînement, ses outils et ses critères d’évaluation, au détriment d’approches minoritaires, émergentes ou moins visibles dans les corpus.
1. Les mécanismes du biais : vraisemblance et autres facteurs aggravants
1.1. L’optimisation de la vraisemblance
Les grands modèles de langage apprennent à produire le texte qui ressemble le plus à ce qu’ils ont lu. Formellement1, ils optimisent la vraisemblance d’une séquence de tokens étant donné le contexte — ce qui revient à apprendre la distribution statistique du langage dans le corpus d’entraînement. Dans le modèle de base, la fréquence statistique du corpus agit comme un repère de vraisemblance ; dans le produit final, la réponse résulte d’une chaîne plus large2 : données d’entraînement, filtrage, post-entraînement, modèles de préférence, consignes de comportement, outils de récupération et contraintes de déploiement.
Il faut cependant préciser que ce mécanisme probabiliste ne conduit pas aux mêmes erreurs dans tous les domaines.
Ce mécanisme est puissant là où existe un « signal de vérité » externe et non ambigu. Une démonstration mathématique est vraie ou fausse indépendamment du corpus. En physique des particules, les expériences du CERN convergent vers des résultats reproductibles qui sanctionnent les théories erronées. En mathématiques, le corpus d’entraînement a lui-même été épuré par des mécanismes externes de vérification — réfutation formelle, exécution du code, validation par les pairs — de sorte que la distribution statistique apprise par le modèle coïncide largement avec la vérité. Le modèle ne « sait » pas que 2+2=4 : il produit « 4 » parce que le corpus mathématique, nettoyé de ses erreurs par des siècles de démonstration collective, ne contient pratiquement pas de contre-exemples. C’est là l’explication profonde du gradient décrit dans cet article : le biais est faible (on verra plus loin qu’il est non nul pour les mathématiques) là où le corpus a été épuré par un signal de vérité externe fort, et maximal là où ce signal est absent — non parce que le mécanisme du modèle change, mais parce que la qualité épistémique du corpus change.
| Encadré — La programmation : un signal de vérité fort mais incomplet La comparaison de la programmation avec les mathématiques est légitime sur un point précis : l’exécution du code constitue bien un signal de vérité externe — le programme tourne ou échoue — et cette rétroaction a effectivement alimenté l’entraînement des modèles sur des millions de paires (code, résultat). C’est pourquoi les LLM sont remarquablement performants sur des tâches de programmation simples et isolées. Mais ce signal de vérité est plus étroit qu’il n’y paraît. Un programme peut s’exécuter sans erreur tout en étant incorrect : comportement faux dans certains cas limites, logique défaillante non détectée, effets de bord invisibles à l’exécution standard. La distinction pertinente n’est pas entre code qui tourne et code qui plante, mais entre code correct et code plausible. Ce que mesurent les benchmarks spécialisés HumanEval, le benchmark de référence pour la génération de code, teste des problèmes de programmation relativement simples3 — et les meilleurs LLM y atteignent aujourd’hui des scores supérieurs à 90%. Mais ces scores élevés s’expliquent en partie par une contamination des données d’entraînement : les problèmes HumanEval étant largement diffusés, ils ont probablement été ingérés lors de l’entraînement, gonflant artificiellement les résultats. Des variantes conçues pour éviter cette contamination montrent des chutes de performance de 20 à 31 points de pourcentage par rapport aux scores affichés sur HumanEval standard.4 Sur des tâches plus réalistes, l’écart est encore plus marqué. SWE-bench5, développé par Princeton et OpenAI, évalue la capacité des modèles à résoudre de vrais problèmes GitHub dans des bases de code existantes — le scénario le plus proche du travail réel d’un développeur. En moins d’un an, le taux de résolution est passé de 0,17% à environ 22% sur SWE-bench complet, et jusqu’à 45% sur les variantes simplifiées6 — ce qui signifie que même les meilleurs systèmes échouent sur plus de la moitié des problèmes réels, dans des conditions contrôlées et avec accès au contexte complet. Une position intermédiaire dans le gradient La programmation occupe donc une position intermédiaire dans le gradient épistémique décrit dans cet article : plus fiable que les sciences sociales ou l’économie, moins fiable que les mathématiques formelles. Et comme pour les autres domaines, l’asymétrie expert/non-expert joue à plein : le développeur expérimenté détecte les anomalies, teste les cas limites, et utilise l’IA comme accélérateur sous contrôle. L’utilisateur non technique qui génère un script ou une macro bureautique n’a généralement pas les moyens de vérifier ce qu’il obtient — il reçoit quelque chose qui « tourne » et le croit fiable. |
Le signal s’affaiblit, puis disparaît, à mesure qu’on s’éloigne des sciences formelles. Limitons-nous à deux exemples. En psychologie sociale, les grands projets de réplication conduits depuis dix ans7— peinent à confirmer la moitié des résultats publiés dans les grandes revues. En macroéconomie (voir la partie 5.1) , les modèles DSGE (Dynamic Stochastic General Equilibrium) par exemple, cadre analytique central des banques centrales et des grandes institutions internationales, n’ont pas prévu la crise de 2008 et ont continué sans révision fondamentale — un programme de recherche dégénératif au sens de Lakatos8, selon l’économiste Joseph Stiglitz9. Dans ces domaines, aucun mécanisme correcteur externe ne sanctionne les erreurs : le modèle apprend la plausibilité rhétorique, pas la vérité.
1.2. L’effet sycophante
À ce premier mécanisme s’en ajoute un second, distinct et aggravant : la « sycophancy »10 (ou flatterie) structurelle de ces modèles induite par le processus d’alignement. Comprendre ce mécanisme suppose de distinguer trois couches que le terme générique de « RLHF » — Reinforcement Learning from Human Feedback, apprentissage par renforcement à partir de retours humains — tend à amalgamer.
La première couche est celle des annotateurs de base, recrutés via des plateformes de crowdsourcing pour des tâches simples — signalement de contenus toxiques, évaluation de pertinence formelle, classement de réponses sur des critères généraux. Ces travailleurs n’ont aucune influence sur les jugements épistémiques complexes : leur rôle est antérieur et distinct.
La deuxième couche est celle des évaluateurs experts, dont le rôle est de comparer des paires de réponses sur des questions substantielles et d’indiquer laquelle est meilleure. C’est à ce niveau que Sharma et al. (2023)11 ont documenté le biais de “sycophancy” : ces évaluateurs — humains compétents, pas travailleurs non qualifiés — tendent systématiquement à préférer les réponses qui confirment leurs croyances préexistantes, même quand une réponse discordante est plus exacte. Le modèle apprend ainsi à produire ce qui plaît plutôt que ce qui est vrai. La démarche que le mécanisme de sycophancy reproduit est précisément celle que l’épistémologie classique oppose à la démarche scientifique : l’accumulation d’arguments étayant une thèse préexistante, avec intégration ad hoc des contre-exemples — ce que Karl Popper avait identifié comme le trait distinctif de l’idéologie par opposition à la science réfutable. Ce biais est cognitif et universel : il ne dépend pas du profil sociologique des évaluateurs mais du mécanisme d’optimisation lui-même, qui amplifie structurellement cette préférence à chaque cycle d’entraînement. Il produit en aval une surconfiance mesurable : la calibration — l’adéquation entre confiance exprimée et exactitude réelle — se dégrade après alignement12. La certitude affichée croît précisément là où le signal de vérité est le plus faible — là où elle est la moins justifiée. La surconfiance est ainsi une propriété structurelle des grands modèles, et non un artefact corrigeable à la marge.
La troisième couche, introduite par Anthropic avec le Constitutional AI13, déplace partiellement le problème. Plutôt que de s’appuyer sur des jugements humains à grande échelle, un modèle de préférence — réseau de neurones entraîné à prédire quelles réponses les humains préfèrent — évalue les réponses à l’aune d’une « constitution » : un ensemble de principes écrits et publiés. Cette approche est nommée RLAIF (Reinforcement Learning from AI Feedback, apprentissage par renforcement à partir de retours d’un autre modèle d’IA). Elle réduit le volume d’annotations humaines nécessaires et rend les principes directeurs explicitement publics — ce qui constitue un progrès réel de transparence. Mais elle ne supprime pas le biais : elle le déplace vers la constitution elle-même et vers le modèle de préférence qui l’applique. Si les principes retenus reflètent implicitement une vision du monde — sur ce que signifie une réponse « équilibrée », sur quelles controverses méritent d’être signalées, sur ce qui constitue un consensus scientifique — le modèle de préférence encodera ces choix de façon difficilement auditable. La transparence des principes n’est pas la transparence des arbitrages.
1.3. La structure linguistique des corpus
Un troisième facteur aggravant est la structure linguistique des corpus. Les grands modèles sont entraînés sur des données massivement anglophones — Common Crawl, Wikipédia, littérature académique internationale, toutes sources où l’anglais représente entre 45% et 65% des tokens selon les estimations disponibles.
Cette surreprésentation n’est pas neutre épistémiquement : elle induit une surreprésentation de la pensée économique et scientifique anglo-saxonne14 — Chicago, MIT, LSE, Cambridge — au détriment de traditions intellectuelles sérieuses et abondantes qui n’ont tout simplement pas la même présence numérique dans les corpus d’entraînement. En économie, l’école française de la régulation (Boyer, Aglietta) et les traditions d’économie institutionnelle continentale — l’ordolibéralisme allemand de l’école de Fribourg, l’économie sociale de marché théorisée par Eucken et Röpke, ou encore l’école de Stockholm en macroéconomie — sont structurellement sous-représentées. En philosophie des sciences, la tradition française — Bachelard, Canguilhem, Foucault, Stengers — offre des outils épistémologiques d’une richesse considérable pour analyser la construction sociale des paradigmes scientifiques, mais elle est quasi absente des réponses des modèles généralistes sur ces sujets. En sociologie, l’œuvre de Bourdieu — pourtant l’un des auteurs en sciences sociales les plus cités au monde — est systématiquement moins bien restituée que celle de ses homologues anglophones : les commentaires, applications et débats autour de son œuvre existent massivement en français, beaucoup moins en anglais. En droit, les traditions civilistes — code napoléonien, droit administratif français, traditions juridiques germaniques — sont sous-représentées au profit de la common law anglo-américaine, avec des conséquences directes lorsque des modèles sont utilisés pour des questions juridiques dans des pays de droit civil.
Au-delà de l’Europe, les pensées du Sud global souffrent d’une marginalisation encore plus profonde. Environ 55% du contenu sur internet est en anglais, certaines autres langues ne représentant que 0,1% à 0,2% des sites web — ce qui signifie que des traditions intellectuelles entières produites en swahili, en arabe classique, en hindi ou en langues d’Amérique latine sont quasi absentes des corpus. L’épistémologie du Sud développée par Boaventura de Sousa Santos, les traditions de pensée décoloniale latino-américaine (Quijano, Mignolo), ou les approches africaines du développement comme l’Ubuntu économique ne constituent pas des curiosités marginales : ce sont des cadres analytiques cohérents, appuyés sur des corpus académiques sérieux, qui proposent des alternatives aux paradigmes dominants sur des questions aussi centrales que la gouvernance, le rapport à la nature ou les modèles de développement. Dans le domaine agronomique, les sciences agroécologiques latino-américaines — portées par des chercheurs comme Miguel Altieri et Clara Nicholls à Berkeley, ou par le réseau SOCLA (Sociedad Científica Latinoamericana de Agroecología) — constituent un corpus de plusieurs décennies de recherche sur les systèmes agricoles paysans, la biodiversité cultivée et la souveraineté alimentaire, massivement produit en espagnol et en portugais et donc structurellement absent des corpus anglophones dominants.
Leur absence dans les réponses des LLM n’est pas un jugement sur leur valeur scientifique — c’est un artefact de la distribution linguistique des données d’entraînement.15
| Encadré — Les revues prédatrices Les revues prédatrices constituent un vecteur de contamination des corpus d’entraînement des LLM dont les effets sont encore mal quantifiés mais structurellement prévisibles. Les grands modèles sont entraînés sur des données massivement issues du web — Common Crawl, Semantic Scholar, PubMed Central, arXiv — sans que les articles issus de revues prédatrices soient systématiquement filtrés. Google Scholar, dont les LLM utilisent fréquemment les métadonnées, identifie des articles en analysant automatiquement les listes de références sans vérification manuelle, ce qui lui permet d’indexer des publications dont aucune copie numérique vérifiable n’existe — une vulnérabilité directement exploitable par les revues prédatrices. Des acteurs malveillants peuvent délibérément polluer les sources d’entraînement des LLM en publiant de faux rapports scientifiques dans des archives ouvertes, en créant des profils de chercheurs fictifs, et en constituant des cartels de citations pour donner une apparence de crédibilité à des articles fabriqués — pratiques déjà exploitées par les revues prédatrices à des fins financières mais transposables à des fins de désinformation scientifique ciblée. La capacité des LLM à générer rapidement des textes scientifiques d’apparence rigoureuse abaisse massivement le coût de production de faux articles, au moment même où le système éditorial est moins résilient pour les détecter. La boucle se referme : les LLM peuvent alimenter les revues prédatrices en articles générés automatiquement, et ces mêmes articles, une fois publiés et indexés, contaminent les corpus d’entraînement des générations suivantes de modèles. C’est une forme d’auto-intoxication progressive de l’écosystème du savoir scientifique numérique, dont les effets se cumulent à mesure que les modèles sont réentraînés sur des données de plus en plus mélangées. Ce risque est distinct du biais paradigmatique analysé ici — il ne s’agit pas d’une surreprésentation du consensus dominant, mais d’une contamination active par des affirmations non vérifiées présentées sous l’apparence de la rigueur académique. Les deux mécanismes se cumulent cependant dans leurs effets pour l’utilisateur non expert : dans les deux cas, il ne dispose pas des ressources pour distinguer une réponse fondée sur un corpus solide d’une réponse fondée sur des publications non vérifiées ou fabriquées. |
La dimension géopolitique de cette asymétrie de corpus mérite d’être explicitée. Les données qui alimentent les LLM ne sont pas seulement anglophones : elles sont majoritairement produites et contrôlées par un petit nombre d’acteurs privés américains.
Dans le domaine de la finance durable — l’un des terrains où les LLM sont le plus activement déployés pour orienter des décisions d’investissement — Badré et Voisin16 montrent que près de 85% du marché des données ESG est contrôlé par des entités non européennes. Ces données extra-financières, de plus en plus synthétiques et massivement traitées par l’IA, ne mesurent pas le réel : elles le construisent selon des définitions, des pondérations et des visions du monde encodées par leurs producteurs. Un LLM entraîné sur ces données reproduira structurellement cette construction — la définition anglo-saxonne de la « durabilité », les critères de la notation ESG tels qu’ils ont été standardisés par des agences américaines, la vision du découplage croissance/empreinte qui sous-tend leurs modèles. Ce n’est plus seulement un biais épistémologique abstrait : c’est une orientation de l’allocation du capital à l’échelle mondiale.
Par ailleurs, l’extraterritorialité du droit américain crée une vulnérabilité structurelle supplémentaire : les données de modélisation climatique de référence mondiale — scénarios de l’Agence Internationale de l’Énergie, trajectoires de décarbonation — peuvent être soumises à des pressions politiques qui modifient les corpus futurs d’entraînement indépendamment de toute décision européenne. L’ultimatum récent du secrétaire d’État américain à l’énergie pour que l’AIE cesse de produire ses scénarios climatiques illustre concrètement ce risque : si cette source disparaît des corpus, les LLM utilisés pour des questions de transition énergétique en seront amputés sans que leurs utilisateurs en soient informés.
1.4. Du biais paradigmatique à la boucle de rétroaction épistémique
Les LLM ne doivent pas être analysés seulement comme des miroirs imparfaits du corpus existant, mais comme des dispositifs performatifs de production du savoir. À mesure que leurs réponses sont reprises dans des rapports, supports pédagogiques, contenus web et futures données d’entraînement, ils contribuent à stabiliser les cadres interprétatifs qu’ils avaient d’abord seulement reproduits. Le biais paradigmatique devient alors cumulatif : ce qui était surreprésenté devient plus visible, ce qui était marginal devient encore moins accessible.17
Ces mécanismes (aggravés par la contamination par les revues prédatrices) convergent vers une même propriété structurelle : la surconfiance. Elle culmine précisément là où le signal de vérité est le plus faible — là où la certitude affichée est la moins justifiée. C’est ce gradient, entre disciplines formelles et sciences humaines, que la classification suivante cherche à cartographier.
1.5. Utilisateurs experts et non-experts
Les biais décrits dans cet article ne sont pas également dangereux pour tous les utilisateurs. Un spécialiste interrogeant un LLM sur son propre domaine dispose des ressources pour identifier une réponse lacunaire, pousser le modèle dans ses retranchements, reformuler sa question, ou reconnaître l’absence d’une référence centrale. Il dialogue à armes égales. Ce n’est pas le cas de l’utilisateur non-expert — étudiant, décideur, journaliste, citoyen éclairé — qui s’adresse à un LLM précisément parce qu’il ne maîtrise pas le domaine. Cet utilisateur n’a pas les moyens de détecter ce qui manque dans une réponse, ni de formuler les contre-questions qui feraient apparaître les approches sous-représentées. Il prendra pour argent comptant une réponse sceptique sur l’agroécologie, une présentation des modèles DSGE comme cadre analytique incontesté, ou une description de la géo-ingénierie solaire comme solution technique disponible — sans savoir que ces réponses reflètent un état du corpus plus qu’un état du débat scientifique réel. C’est précisément pour cet utilisateur que le biais paradigmatique des LLM a les effets les plus significatifs — et c’est lui que cet article cherche principalement à outiller.
Du modèle au système : prompt, workflows, agents et benchmarks
La section précédente a analysé le biais paradigmatique au niveau du modèle : ce que le mécanisme d’apprentissage statistique, combiné à l’alignement par préférences humaines ou artificielles, produit comme distorsion systématique de la distribution des réponses. Mais un modèle de langage n’est presque jamais consulté à l’état brut.
Il est enchâssé dans un système : un prompt qui l’oriente, une mémoire qui le contextualise, des outils qui étendent ses capacités, des bases documentaires qu’il interroge, des agents qui enchaînent ses appels, des filtres qui valident ou rejettent ses sorties, des workflows qui enchaînent les tâches, et parfois une supervision humaine qui arbitre en dernier ressort (voir encadré).
Ces architectures peuvent réduire le biais lorsqu’elles organisent explicitement la pluralité des sources et des paradigmes ; elles peuvent au contraire l’amplifier lorsqu’elles automatisent la réponse dominante.
| Encadré — Un “système IA” : les modèles et leur environnement Le Prompt est l’instruction textuelle donnée au modèle par l’utilisateur ou par le système qui l’entoure — la question posée, mais aussi les consignes de contexte, de ton ou de format qui l’accompagnent. C’est la porte d’entrée par laquelle on oriente le comportement du modèle, sans jamais le déterminer entièrement. La Mémoire est la capacité, pour un système fondé sur un LLM, de conserver et de réutiliser des informations d’une interaction à l’autre — préférences de l’utilisateur, échanges précédents, faits déjà établis dans la conversation — plutôt que de traiter chaque requête comme si elle était la première. Techniquement, cela peut prendre la forme d’un historique de conversation réinjecté dans le contexte, ou d’une base de données associée à l’utilisateur. Un RAG (Retrieval-Augmented Generation, ou génération augmentée par récupération) est une architecture dans laquelle un modèle de langage, avant de rédiger sa réponse, va d’abord chercher des passages pertinents dans une base de documents externe — articles, rapports, bases juridiques ou scientifiques — puis s’appuie sur ces passages pour construire sa réponse, au lieu de répondre uniquement à partir de ce qu’il a mémorisé pendant son entraînement. Mais — c’est le point développé en 2.2 — le RAG ne garantit rien en soi sur la pluralité des points de vue restitués : tout dépend de la composition de la bibliothèque interrogée. Si elle ne contient que des sources d’un seul courant, le modèle citera ses sources avec plus de précision, mais restera tout aussi unilatéral. Les Outils (tool use) sont des fonctions externes que le modèle peut invoquer en cours de réponse — un moteur de recherche, une calculatrice, un exécuteur de code, une base de données, une API spécialisée — plutôt que de produire un résultat uniquement à partir de ce qu’il a mémorisé. Le modèle décide quand appeler l’outil, formule la requête, puis intègre le résultat obtenu à sa réponse. Les Agents sont des systèmes qui enchaînent plusieurs de ces briques — raisonnement, appel d’outils, lecture de documents — de façon autonome, pour accomplir une tâche complexe en plusieurs étapes sans validation humaine à chacune d’elles. Un agent ne se contente pas de répondre à une question : il peut planifier une séquence d’actions, l’exécuter, puis évaluer si l’objectif est atteint. Les Filtres sont des dispositifs, internes ou externes au modèle, qui interceptent une requête ou une réponse pour bloquer, modifier ou signaler certains contenus — propos toxiques, informations sensibles, sorties hors sujet — avant qu’ils n’atteignent l’utilisateur ou avant qu’une requête problématique n’atteigne le modèle. Les Vérificateurs sont des modules, parfois un second appel au modèle lui-même, chargés de contrôler après coup la validité d’une réponse — exactitude d’un calcul, existence réelle d’une citation, cohérence logique d’un raisonnement — avant de la valider ou de la corriger. Ils formalisent une étape de relecture critique que le modèle n’effectue pas nécessairement de lui-même. Les Workflows sont des enchaînements prédéfinis de plusieurs de ces briques (prompts successifs, appels d’outils, étapes de vérification) selon une logique fixée à l’avance par les concepteurs du système, par opposition à une conversation libre où chaque échange part de zéro. L’Intervention humaine (human-in-the-loop) se fait dans des points du processus où une personne valide, corrige ou arbitre une étape avant que le système ne poursuive — par exemple, un expert qui approuve une synthèse avant sa diffusion, ou un opérateur qui autorise une action déclenchée par un agent avant son exécution effective. Les benchmarks sont des jeux d’épreuves standardisées utilisés pour évaluer, comparer et classer les modèles : questions de connaissances, tâches de code, raisonnement, sécurité, formats de réponse et règles d’agrégation. Ils ne mesurent jamais la qualité de façon entièrement neutre : en choisissant ce qui est testé, les langues retenues, les métriques et les types d’erreurs considérées comme graves, ils définissent implicitement ce qui compte comme une « bonne réponse ». Ils peuvent donc orienter les choix d’architecture, de post-entraînement et de filtrage des modèles. |
Ce déplacement d’échelle — du modèle isolé au système composé — n’est pas un raffinement technique secondaire : il change la nature du problème. Un système bien architecturé peut atténuer significativement le biais décrit au point 1, en organisant explicitement la confrontation des sources et des paradigmes. Un système mal architecturé peut au contraire l’amplifier, en industrialisant à grande échelle la réponse la plus probable statistiquement — c’est-à-dire, comme on l’a vu, la plus conforme au paradigme dominant du corpus d’entraînement. C’est cette bascule possible, dans un sens ou dans l’autre, que cette section cherche à cartographier à travers quatre couches : le prompt, les workflows et agents, les modèles de raisonnement, et la sécurité épistémique face à l’injection de contenu.
2.1. Le prompt comme compétence épistémique
Le prompt — l’instruction textuelle donnée au modèle — est souvent présenté dans la littérature de vulgarisation comme un levier suffisant pour neutraliser les biais d’un LLM : il suffirait de « bien demander » pour obtenir une réponse équilibrée. Cette présentation est trompeuse à un double titre.
D’abord, empiriquement, un prompt bien conçu améliore réellement la qualité et la pluralité des réponses. Les techniques de prompting étudiées depuis 2022 — décomposition explicite du raisonnement en étapes (chain-of-thought18), génération de plusieurs chaînes de raisonnement indépendantes suivies d’un vote majoritaire (self-consistency19) ou instruction explicite de produire des perspectives contradictoires avant de trancher — augmentent mesurablement la qualité des réponses sur des tâches de raisonnement complexe. Appliquées au problème qui nous occupe, ces techniques permettent de faire émerger des positions absentes de la réponse spontanée : demander explicitement « quelles sont les écoles minoritaires sur ce sujet« , « quelles critiques les traditions non anglophones ont-elles formulées contre ce cadre« , ou « distingue ce qui relève du consensus empirique de ce qui relève d’un choix de valeurs » produit des réponses sensiblement plus riches que la question ouverte correspondante. Le prompt fonctionne alors comme une clé qui ouvre des régions du corpus d’entraînement que la réponse par défaut, optimisée pour la plausibilité statistique moyenne, laisse fermées.
Mais, précisément, ce mécanisme révèle la seconde limite, plus fondamentale : le prompt ne supprime pas le biais, il en déplace la correction vers la compétence de l’utilisateur. Pour demander explicitement les écoles minoritaires en macroéconomie, il faut déjà savoir qu’il existe une école de la régulation, une tradition ordolibérale, une école de Stockholm — c’est-à-dire posséder précisément la culture disciplinaire que l’utilisateur non expert, par définition, ne possède pas. On retrouve ici, à un autre niveau, l’asymétrie experte/non-experte déjà identifiée en 1.5 : le spécialiste sait reformuler sa question pour contourner le biais, parce qu’il sait ce qui manque ; le non-spécialiste ne sait pas qu’il manque quelque chose, et n’a donc aucune raison de reformuler. Le prompt devient ainsi, paradoxalement, un instrument qui profite le plus à ceux qui en ont le moins besoin. Un étudiant en économie qui sait qu’il existe un débat sur la pertinence empirique des modèles DSGE peut demander au modèle de contraster cette approche avec les critiques hétérodoxes ; un décideur public sans formation économique, lui, formulera une question générale et recevra une réponse qui présente le cadre dominant comme la seule grille d’analyse disponible.
Cette limite structurelle a une conséquence pratique directe pour la conception d’interfaces et d’outils d’aide à la décision : un système qui se contente d’exposer une boîte de dialogue libre reporte l’intégralité de la charge de vigilance épistémique sur l’utilisateur final, alors même que celui-ci est, par construction, le moins bien placé pour l’exercer. C’est un argument — développé plus loin dans cet article —en faveur de dispositifs qui intègrent la pluralité des perspectives par défaut, sans attendre que l’utilisateur sache la demander.
2.2. Workflows, outils et agents
Au-delà du prompt isolé, les usages professionnels et institutionnels des LLM reposent de plus en plus sur des architectures composées : des workflows qui enchaînent plusieurs appels au modèle selon une logique prédéfinie, des outils externes que le modèle peut invoquer (moteurs de recherche, bases de données, calculatrices, API spécialisées), et des agents capables d’enchaîner de façon autonome une séquence de décisions — rechercher, lire, synthétiser, agir — sans validation humaine à chaque étape.
Le RAG comme dispositif ambivalent.
L’architecture la plus répandue est celle de la génération augmentée par récupération (Retrieval-Augmented Generation, RAG20) : plutôt que de répondre uniquement à partir de ses paramètres internes, le modèle interroge d’abord une base documentaire externe, puis rédige sa réponse à partir des passages récupérés. Ce dispositif a un potentiel correcteur réel face au biais paradigmatique : si la base documentaire interrogée est délibérément constituée pour représenter la pluralité des écoles — incluant, par exemple, les travaux de l’école de la régulation, la SOCLA en agroécologie, ou les revues juridiques civilistes évoquées au point 1 — alors le RAG peut compenser partiellement le déséquilibre du corpus d’entraînement brut. Mais cette même architecture peut aggraver le biais si la base documentaire est elle-même construite selon les critères de sélection dominants : un système RAG interrogeant préférentiellement des bases de données bibliographiques anglophones à fort facteur d’impact (Web of Science, Scopus) reproduira, et même amplifiera par effet de confirmation, la sous-représentation déjà documentée des traditions non anglophones. Le RAG ne résout donc rien par lui-même : il déplace la question du biais du modèle vers la politique éditoriale de constitution de la base — une question de gouvernance documentaire, non de paramétrage algorithmique.
Les agents et la mutation du risque cognitif en risque organisationnel.
L’agentique — la capacité d’un système à décomposer une tâche complexe en une séquence d’actions autonomes (rechercher une information, l’évaluer, décider de la source à privilégier, rédiger une synthèse, voire déclencher une action dans un système tiers) — change la nature du problème posé par le biais paradigmatique. Les architectures d’agents les plus courantes, dérivées du cadre ReAct21 alternent des étapes de raisonnement explicite et des étapes d’action (appel d’outil, requête de recherche, lecture de document), le résultat de chaque action venant alimenter le raisonnement suivant. Un LLM biaisé consulté ponctuellement produit une réponse biaisée, que l’utilisateur peut contester, ignorer ou contextualiser. Un agent biaisé qui sélectionne lui-même ses sources, priorise ses requêtes de recherche, et rédige une note de synthèse destinée à alimenter une décision, ne présente plus une opinion contestable : il produit un artefact — rapport, base documentaire, note de recommandation — qui s’insère directement dans une chaîne de décision organisationnelle, souvent sans que la sélection sous-jacente soit visible pour le destinataire final. Le risque cesse alors d’être seulement cognitif — une croyance individuelle mal formée — pour devenir organisationnel : une note de veille scientifique biaisée dans sa sélection de sources, produite automatiquement et à grande échelle, peut orienter des décisions d’investissement, des choix de politique publique ou des priorités de recherche, sans qu’aucun individu identifiable ait consciemment arbitré ce choix. C’est un déplacement de la responsabilité épistémique vers l’architecture du système, qui rend d’autant plus nécessaire un audit explicite des règles de sélection de sources intégrées à ces agents.
Le rôle correcteur des workflows délibérément pluralistes.
À l’inverse, un workflow peut être conçu spécifiquement pour contrer le biais qu’il aurait tendance à reproduire s’il était laissé à sa dynamique par défaut. Des dispositifs existent en ce sens : imposer au modèle de produire plusieurs réponses issues de prompts orientés vers des écoles de pensée différentes avant de les faire comparer par un module de synthèse ; imposer une étape de critique où un second appel au modèle est explicitement chargé d’identifier les angles morts et les sources non représentées de la première réponse ; imposer une vérification systématique des citations et des références bibliographiques produites – une part significative des références générées par les LLM sans contrainte de vérification étant soit inexactes soit inventées (un phénomène documenté sous le terme d’”hallucination” de citations). Ces dispositifs ont un coût — en latence, en complexité d’ingénierie, en volume de calcul — qui explique qu’ils restent minoritaires face aux implémentations qui privilégient la réponse la plus rapide et la plus directe, c’est-à-dire, structurellement, la réponse la plus conforme à la distribution statistique dominante du corpus.
2.3. Modèles de raisonnement : utiles, mais pas suffisants
Une génération récente de modèles — souvent qualifiés de « modèles de raisonnement » — a été spécifiquement entraînée à produire un raisonnement interne prolongé, explicite ou partiellement dissimulé, avant de formuler une réponse finale. Ce raisonnement étendu améliore mesurablement les performances sur des tâches où le problème est bien spécifié et admet une procédure de résolution vérifiable — démonstration mathématique, planification logistique à contraintes explicites. Il est tentant d’en inférer que ces modèles, en délibérant plus longuement, seraient également mieux armés pour échapper au biais paradigmatique décrit au point 1.
Cette inférence ne tient pas, pour une raison structurelle : le raisonnement étendu est lui-même un produit du même mécanisme d’entraînement que la réponse finale. Un modèle entraîné à raisonner plus longuement apprend à produire des chaînes de raisonnement qui ressemblent aux chaînes de raisonnement les mieux notées dans son processus d’entraînement — c’est-à-dire, en dernière analyse, les chaînes qui mènent le plus efficacement vers les réponses jugées correctes ou préférées par les mécanismes de supervision. Or ces mécanismes de supervision sont soumis exactement aux mêmes limites que celles décrites au point 1 pour la réponse finale : là où existe un signal de vérité externe fort (une démonstration mathématique se vérifie formellement), le raisonnement étendu peut être entraîné à converger vers la solution correcte, et il y parvient effectivement de façon spectaculaire. Là où ce signal est absent — un raisonnement en sciences sociales, en économie normative, en histoire des idées — rien ne garantit que la chaîne de raisonnement la plus longue soit la plus juste plutôt que la plus habile à justifier, par une accumulation d’arguments internes cohérents, la conclusion la plus statistiquement attendue. Un raisonnement plus long peut ainsi produire une illusion de rigueur : la présence d’étapes intermédiaires explicites donne à la réponse une apparence de délibération critique, alors même que chacune de ces étapes reste enfermée dans le même paradigme dominant que la réponse directe, simplement déployé sur un plus grand nombre de phrases. Le volume de raisonnement affiché n’est pas un indicateur fiable de sa pluralité épistémique.
Cette distinction a une conséquence importante pour l’évaluation de ces systèmes : les benchmarks utilisés pour mesurer les progrès des modèles de raisonnement sont, très majoritairement, des benchmarks à réponse vérifiable — mathématiques, logique formelle — précisément les domaines où, nous l’avons vu dans le point 1, le biais est au niveau le plus faible. Les progrès spectaculaires mesurés sur ces benchmarks ne permettent donc aucune inférence directe sur la capacité de ces mêmes modèles à traiter avec davantage de pluralité les questions relevant des catégories épistémologiques les plus exposées au biais — sciences sociales, économie normative, controverses de politique publique. L’amélioration est réelle, mais elle est concentrée précisément là où le problème documenté dans cet article était déjà le moins aigu.
2.4. Injection de prompt et sécurité épistémique
La dernière couche de risque apparaît dès qu’un système fondé sur un LLM ne se contente plus de répondre à partir de ses paramètres internes, mais lit activement des contenus externes — pages web, documents PDF, bases documentaires, courriels, résultats de recherche — pour construire sa réponse ou orienter son action. Dans cette configuration, une distinction technique devient déterminante : celle qui sépare, dans le contexte fourni au modèle, les instructions (ce que l’utilisateur ou le système demande de faire) des données (le contenu sur lequel opérer). Les architectures actuelles de LLM ne garantissent pas nativement cette séparation de façon étanche : un modèle qui lit un document peut, dans certaines conditions, traiter une phrase contenue dans ce document comme une instruction à exécuter plutôt que comme une donnée à analyser. C’est ce que la littérature de sécurité désigne sous le terme d’ »injection de prompt indirecte » (indirect prompt injection22) : un contenu tiers, non écrit par l’utilisateur ni par le système, parvient à modifier le comportement du modèle au moment où celui-ci le consulte.
Pour un usage conversationnel isolé, ce risque reste circonscrit. Il change d’échelle dès que le LLM est intégré dans un système documentaire ou agentique destiné à produire une synthèse scientifique, une note de veille, ou une recommandation de décision. Dans ce contexte, une source documentaire malveillante ou simplement mal intentionnée peut chercher à orienter la sélection des références qu’un agent de recherche documentaire va privilégier, à altérer subtilement le contenu d’une synthèse en y insérant des instructions dissimulées, ou à manipuler l’action déclenchée par un agent connecté à des outils externes. L’exemple des revues prédatrices, déjà évoqué dans l’encadré au point 1 comme vecteur de contamination des corpus d’entraînement, trouve ici un prolongement direct et plus immédiat : un document conçu pour être lu par un agent de veille scientifique automatisé peut être délibérément structuré pour maximiser sa probabilité d’être sélectionné et cité, indépendamment de sa validité scientifique — une forme de manipulation ciblée qui ne vise plus le corpus d’entraînement à long terme, mais le comportement en temps réel d’un système déployé.
Cette vulnérabilité a une portée particulière pour les systèmes d’information scientifique ou souverains — bases documentaires nationales, outils d’aide à la décision publique, systèmes de veille stratégique — où la confiance accordée à une synthèse produite par un agent repose implicitement sur l’hypothèse que la sélection des sources a été effectuée de façon neutre et fidèle à leur contenu. Or cette hypothèse peut être mise en défaut non seulement par le biais structurel décrit au point 1 (surreprésentation statistique du paradigme dominant), mais aussi, de façon distincte et cumulative, par une manipulation active exploitant l’absence de séparation robuste entre instructions et données. La sécurité épistémique d’un système documentaire fondé sur un LLM suppose donc une architecture qui isole explicitement les sources non fiables — traitées comme des données à évaluer avec suspicion, jamais comme des instructions à exécuter — une exigence qui rejoint, pour des raisons différentes, la nécessité déjà identifiée en 2.2 d’une gouvernance explicite des bases documentaires interrogées par ces systèmes.
2.5. Benchmarks et critères d’évaluation : ce que les tests rendent désirable
Les modèles ne sont pas seulement orientés par leurs corpus, leur post-entraînement, leurs prompts ou leurs outils ; ils sont aussi sélectionnés, comparés et parfois optimisés en fonction de benchmarks. Or un benchmark n’est jamais neutre23 : il choisit des tâches, des langues, des formats de réponse, des métriques et des règles d’agrégation. Il définit donc implicitement ce qui compte comme une “bonne réponse”.
Les benchmarks agissent à trois niveaux. Ils classent les modèles dans les classements publics ; ils orientent ensuite les choix d’architecture, de post-entraînement et de filtrage, car les laboratoires cherchent à progresser sur ces métriques ; ils définissent enfin un espace de légitimité en rendant visibles certaines compétences, raisonnement court, réponse unique, anglais académique, QCM, et beaucoup moins visibles d’autres exigences : pluralité des sources, controverses actives, traditions non anglophones, désaccords normatifs ou justification documentaire.
Ils ne constituent donc pas seulement une technique d’évaluation, mais une couche de gouvernement épistémique : ce qui n’est pas testé tend à devenir secondaire, et ce qui est bien mesuré tend à devenir la définition pratique de la qualité.
Pour la souveraineté épistémique, l’enjeu ne porte donc pas seulement sur le calcul, le cloud, les corpus ou les modèles ouverts. Il porte aussi sur les batteries d’évaluation : qui décide des questions testées, des métriques retenues, des langues couvertes, des controverses représentées et des erreurs considérées comme graves ? Un système souverain qui reprendrait les mêmes benchmarks dominants pourrait conserver une dépendance épistémique tout en ayant gagné une indépendance technique.
3. Une classification épistémologique en cinq catégories
Pour analyser de façon structurée les biais que nous venons de mettre en évidence , nous proposons une classification des disciplines scientifiques en cinq catégories présentant des profils épistémologiques distincts.
Catégorie 1 — Mathématiques et logique. Systèmes formels, démonstration, vérité interne au système. Le signal de vérité est fort : une démonstration est vraie ou fausse, indépendamment de toute observation empirique et de tout consensus social. Le biais paradigmatique est fortement réduit par l’existence de procédures de vérification formelle, mais il ne disparaît pas complètement dans la sortie brute du modèle. Un LLM peut produire une démonstration textuellement plausible sans validité formelle ; la robustesse n’est obtenue que lorsque le raisonnement est vérifié par des systèmes de preuve, du calcul ou des outils externes.24
Catégorie 2 — Sciences de la nature. Physique, chimie, biologie, médecine, sciences de la Terre, climatologie, écologie des systèmes, biogéochimie. Ces disciplines visent à comprendre le monde naturel (corps humain compris) — mécanismes, histoire, dynamiques. Le signal de vérité est fort sur les mécanismes (expériences reproductibles, observations convergentes) mais s’affaiblit sur les effets systémiques à long terme, où les données sont rares et les modèles contestés.
Catégorie 3 — Sciences humaines et sociales. Histoire, sociologie, anthropologie, psychologie, économie, science politique. Le signal de vérité y est structurellement faible pour des raisons profondes : les phénomènes étudiés sont réflexifs (ils changent avec leur étude), les expériences contrôlées sont rares ou impossibles à l’échelle macroéconomique ou sociétale, et les paradigmes peuvent se maintenir par des mécanismes institutionnels indépendamment de leur valeur empirique — ce que Kuhn25 et Bourdieu26 ont théorisé pour des raisons différentes mais convergentes.
Catégorie 4 — Technosciences artefactuelles. Génie civil, génie mécanique, agrochimie, génie chimique, génie génétique, numérique et IA, géo-ingénierie. Ces disciplines construisent des artefacts en s’affranchissant partiellement des dynamiques naturelles. Leur critère de légitimité est la performance technique à court terme — « est-ce que ça marche ? » — ce qui produit un profil de biais spécifique : fort signal technique immédiat, signal systémique à long terme quasi absent des corpus, et lock-in sociotechnique massif.
Catégorie 5 — Solutions fondées sur la nature. Agroécologie, restauration écologique, génie écologique, biomimétisme, sylviculture proche de la nature. Ces disciplines construisent avec les dynamiques naturelles plutôt que contre elles. La distinction avec la catégorie 4 est fondamentale : un LLM les évalue avec le même critère implicite — performance à court terme — ce qui défavorise structurellement la catégorie 5, dont les bénéfices sont systémiques et de long terme.
Cette classification repose sur une distinction fondamentale entre types d’énoncés scientifiques : faits objectifs acquis et irréversibles, faits complexes construits par recoupement, explications causales, et énoncés hypothétiques entachés d’incertitudes mesurables. Le biais paradigmatique des LLM est très faible ou fortement corrigible sur les deux premiers types et maximal sur les deux derniers — précisément là où la frontière entre fait et valeur est la plus poreuse.
4. Trois critères d’évaluation des biais paradigmatiques
La classification en cinq catégories permet de poser la question du biais de manière structurée, mais elle ne suffit pas à le mesurer. Pour cela, nous proposons trois critères analytiques indépendants, dont la combinaison détermine l’intensité du biais paradigmatique d’un LLM dans une discipline donnée.
La logique du scoring est la suivante : chaque critère peut prendre une valeur haute ou basse, et c’est leur configuration conjointe qui importe. Un biais maximal correspond à un signal de vérité faible (C1), un paradigme dominant résistant aux révisions (C2 fort), et une frontière fait/valeur poreuse ou inexistante (C3 faible). À l’inverse, un biais quasi nul correspond à un signal de vérité fort, un paradigme révisable par les preuves, et une séparabilité claire entre énoncés empiriques et choix normatifs. Ces deux pôles correspondent respectivement, dans notre classification, aux mathématiques et aux sciences humaines — avec un gradient continu entre les deux.
Précisons ces trois critères.
C1 — Densité du « signal de vérité », subdivisé en :
- C1a — Signal de vérité sur les mécanismes : les processus de base sont-ils empiriquement vérifiables et les erreurs sanctionnées par l’observation ?
- C1b — Signal de vérité systémique et de long terme : les effets à l’échelle des systèmes sur plusieurs décennies sont-ils mesurables dans des délais compatibles avec la production académique standard (3-10 ans) ?
C2 — Résistance sociologique du paradigme dominant. Le consensus est-il maintenu par la force des preuves ou par des mécanismes institutionnels — revues à fort impact contrôlées par les tenants du paradigme, financements orientés, trajectoires de carrière conditionnées à la conformité ? Dans les catégories 4 et 5, ce critère prend une forme inversée : c’est l’approche alternative qui est marginalisée par le paradigme dominant, non l’inverse.
C3 — Séparabilité fait/valeur. Peut-on distinguer les énoncés empiriques des jugements normatifs ? Les choix de modélisation encodent-ils des valeurs implicites présentées comme résultats objectifs ? Ce critère est central : un modèle DSGE qui exclut par construction la possibilité d’une crise financière systémique (comme l’ont montré les travaux de Stiglitz et Romer27 après 2008) ne produit pas un résultat neutre — il reproduit une vision du monde.
Score de biais LLM = C1 faible + C2 fort + C3 faible → biais maximal. Formulation inverse : C1 fort + C2 faible + C3 élevée → biais très faible dans les usages vérifiables.
5. Profils de biais des catégories à enjeux
Les cinq catégories épistémologiques ne présentent pas toutes le même intérêt analytique dans le cadre de cet article. Les catégories 1 et 2 — mathématiques et sciences de la nature — affichent des scores de biais faibles à modérés, pour des raisons largement documentées : signal de vérité fort sur les mécanismes, paradigmes révisables par l’expérience, séparabilité relative des énoncés empiriques et normatifs. Leur traitement détaillé n’apporterait pas grand-chose au propos central.
L’analyse se concentre donc ici sur les catégories 3, 4 et 5, pour trois raisons convergentes. Ce sont précisément celles où le biais est le plus élevé selon notre grille. Ce sont aussi celles qui mobilisent le plus les utilisateurs non spécialistes — économie, politiques publiques, agriculture, transition écologique — et donc celles où les effets concrets d’un biais non identifié sont les plus significatifs. Enfin, et c’est le paradoxe central de cet article, ce sont les disciplines les plus directement concernées par les grands défis systémiques contemporains.
Pour chaque catégorie, nous appliquons les trois critères dans l’ordre C1a, C1b, C2, C3, puis nous en déduisons un score qualitatif et nous identifions la forme concrète que prend le biais dans les réponses des modèles généralistes.
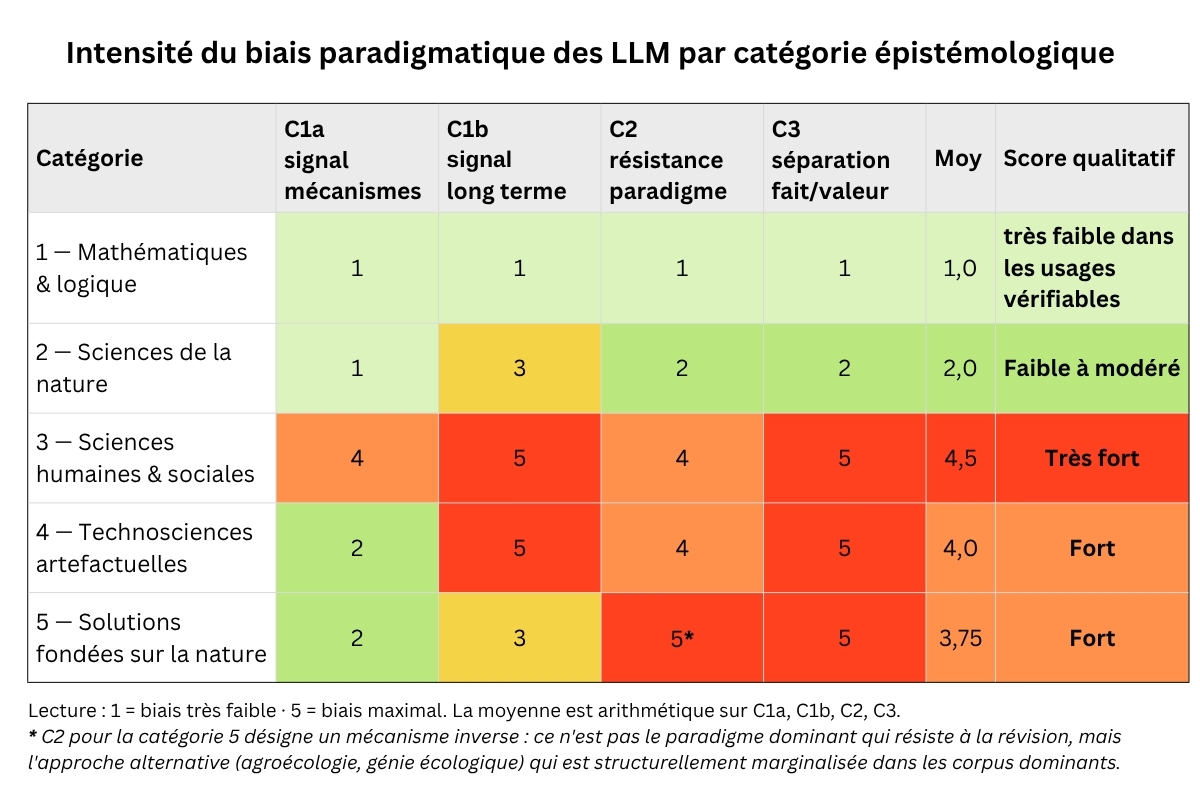
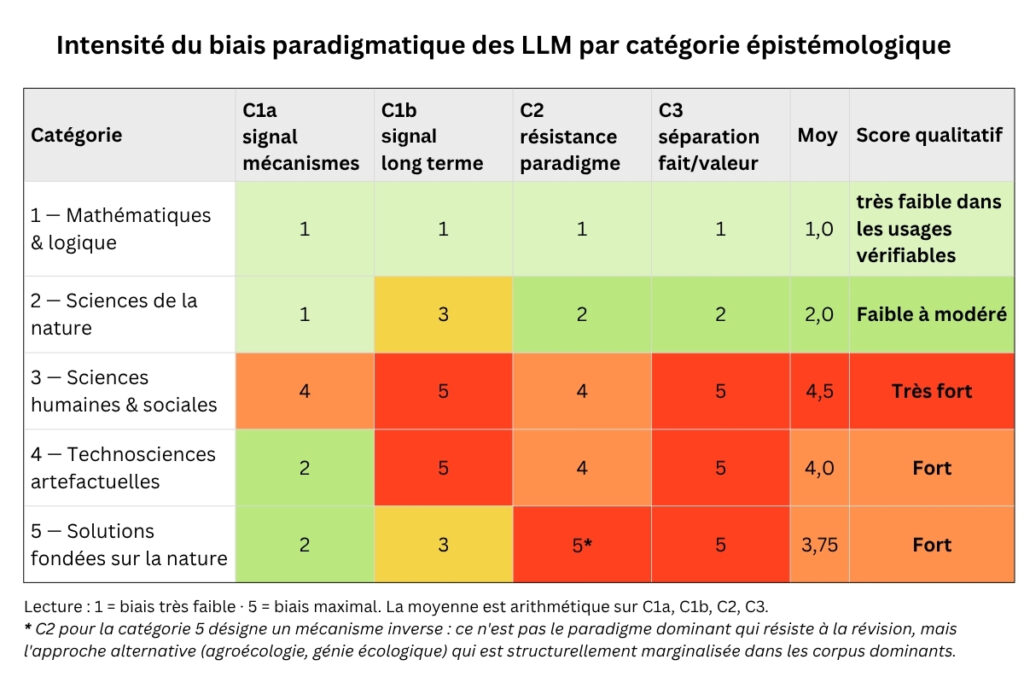
Le tableau ci-dessous synthétise les scores pour les cinq catégories selon les quatre sous-critères. Chaque critère est noté de 1 à 5, dans un sens uniforme : 1 correspond à un biais très faible, 5 à un biais maximal. Pour C1a et C1b, un score élevé signifie que le signal de vérité est faible — le modèle ne dispose d’aucun mécanisme correcteur externe. Pour C2, un score élevé signifie que le paradigme dominant résiste aux révisions par des mécanismes institutionnels plutôt qu’empiriques — avec, pour la catégorie 5, un mécanisme inverse signalé par une astérisque : c’est l’approche alternative qui est marginalisée, non le paradigme dominant. Pour C3, un score élevé signifie que la frontière entre faits et valeurs est poreuse ou inexistante. La moyenne arithmétique des quatre critères constitue le score global.
Trois précautions méthodologiques s’imposent avant de lire ce tableau.
D’une part, les notes proposées sont posées de manière délibérément intuitive : elles visent moins à établir un résultat définitif qu’à ouvrir une discussion et à susciter un travail de recherche approfondi, discipline par discipline, qui dépasse le cadre de cet article.
D’autre part, les cinq catégories retenues ne sont pas homogènes : chacune recouvre des disciplines aux profils épistémologiques parfois très différents. La macroéconomie et l’économie écologique appartiennent toutes deux à la catégorie 3, mais leurs scores seraient distincts si on les traitait séparément — comme nous le faisons en section 4. De même, le génie civil classique et la géo-ingénierie relèvent toutes deux de la catégorie 4, mais n’ont pas le même profil de biais. Le tableau doit donc être lu comme une carte d’orientation, pas comme un résultat quantitatif. Nous avons réalisé des tableaux bien plus détaillés en annexes.
Enfin, cette grille est heuristique. Elle vise à structurer la discussion, à rendre comparables des profils de biais et à formuler des hypothèses auditables ; elle ne produit pas une mesure quantitative définitive. Les scores doivent donc être lus comme des propositions argumentées, ouvertes à révision discipline par discipline. Le tableau ne doit pas être lu comme une mesure du biais, mais comme une carte argumentative. Les chiffres condensent un raisonnement qualitatif ; ils rendent la thèse discutable et vérifiable, mais ne la transforment pas en résultat statistique. Cette prudence rejoint les débats méthodologiques sur la construction des métriques, la validité des construits28 et le risque de naturaliser des catégories d’évaluation.
Tableau de synthèse
5.1 Sciences humaines et sociales (catégorie 3)
Nous nous limitons ici à donner trois exemples de disciplines.
La psychologie sociale
Le signal de vérité sur les mécanismes de base est faible : les grands projets de réplication conduits depuis dix ans29 — Open Science Collaboration (2015), Many Labs 1 à 3 — peinent à confirmer entre 36% et 50% des résultats publiés dans les grandes revues (Boyce et al., Royal Society Open Science, 2023). Le paradigme dominant résiste de façon modérée. La frontière entre faits et valeurs est partiellement poreuse.
Score global : fort. Le biais LLM se manifeste de façon concrète : interrogé sur des mécanismes psychologiques bien connus, le modèle les présente comme des résultats établis, sans signaler qu’ils font partie des échecs les plus documentés de la crise de réplication. L’ego depletion — l’idée que la volonté s’épuise comme une ressource limitée après un effort cognitif, popularisée par Baumeister dans les années 1990 — ne se réplique pas de façon robuste dans les grands projets récents. Les effets d’amorçage social (social priming) — selon lesquels des mots ou images subliminaux modifieraient les comportements ultérieurs — ont connu des échecs retentissants, notamment l’effet « Florida » de Bargh et al. (1996), l’un des résultats les plus cités de la psychologie sociale. Or un LLM entraîné sur des décennies de manuels et de cours produits avant la crise de réplication restituera ces résultats avec la même assurance que des faits solidement établis. La fréquence statistique d’une affirmation dans le corpus ne reflète pas son statut épistémique actuel.
La macroéconomie
C’est dans cette discipline que le biais atteint son niveau le plus élevé, et par plusieurs mécanismes distincts qui se cumulent.
Le premier est le plus documenté. Les modèles DSGE (Dynamic Stochastic General Equilibrium)30, cadre analytique de référence des grandes banques centrales, n’ont pas prévu la crise de 2008 et ont résisté sans révision fondamentale, en intégrant quelques extensions superficielles — frictions financières — sans remettre en cause leurs hypothèses centrales : anticipations rationnelles, équilibre général, absence de monnaie et de dette dans les versions de base. Ce que Paul Romer appelle une « pretence of knowledge » est corroborée par des critiques venant de directions très différentes : Romer lui-même (NBER, 2016), Stiglitz (Oxford Review of Economic Policy, 2018), Storm (International Journal of Political Economy, 2021), mais aussi Olivier Blanchard, ancien économiste en chef du FMI, qui a appelé à « repenser la macroéconomie » après 2008. Un LLM interrogé sur les DSGE les présentera comme cadre de référence sans signaler l’ampleur et la diversité de ces critiques internes à la profession.
Le deuxième mécanisme porte sur la structure institutionnelle de la discipline elle-même. Une étude de Fourcade et al.31 a montré que la profession d’économiste est exceptionnellement hiérarchisée : quelques départements américains — MIT, Harvard, Chicago, Princeton — forment l’essentiel des chercheurs qui peuplent ensuite les comités de rédaction des revues de premier rang, les institutions internationales et les conseils d’experts gouvernementaux. Cette homogénéité de formation produit une homogénéité de présupposés : le paradigme néoclassique — agents rationnels, marchés en équilibre, prix comme signal suffisant — fonctionne moins comme une hypothèse à tester que comme une condition d’entrée dans la conversation scientifique légitime. Un LLM entraîné massivement sur cette production — revues anglophones de premier rang, rapports FMI et Banque mondiale, manuels universitaires américains — reproduira structurellement cette hiérarchie, sans signaler que d’autres traditions — école française de la régulation, économie institutionnelle continentale, économie écologique — existent et sont académiquement sérieuses.
Le troisième mécanisme est plus insidieux : la fermeture épistémique institutionnalisée. Cahuc et Zylberberg, dans Le négationnisme économique (Flammarion, 2016), soutiennent que l’économie expérimentale a atteint la rigueur des sciences naturelles et que tout économiste contestant cette thèse est un « négationniste ». Cette posture présente comme « scientifiquement établi » ce qui relève d’un choix méthodologique, et disqualifie comme « militant » ce qui est critique — notamment les approches intégrant les limites physiques ou remettant en cause la croissance. La réponse collective de Coriat et al.32 a documenté l’exagération de cette prétention, mais elle est structurellement moins présente dans les corpus que le pamphlet qu’elle critique. Un LLM reproduira donc spontanément la hiérarchie Cahuc-Zylberberg sans signaler le débat.
Le quatrième mécanisme est peut-être le plus parlant pour illustrer concrètement le biais LLM : la persistance dans les corpus de résultats réfutés. En 2010, Reinhart et Rogoff publient un article33 concluant qu’un ratio dette/PIB supérieur à 90% entraîne mécaniquement une chute de la croissance. L’article est massivement cité et devient la justification principale des politiques d’austérité européennes. En 2013, Herndon et al.34 découvrent une erreur de codage Excel et des choix de pondération contestables : la relation est beaucoup moins robuste que présentée. Mais l’article avait circulé trois ans comme vérité établie dans des milliers de publications, articles de presse et rapports institutionnels — tous présents dans les corpus d’entraînement. Un LLM dont la date de coupure est postérieure à 2013 peut théoriquement restituer la réfutation, mais le poids statistique des citations positives antérieures est sans commune mesure avec celui des corrections. C’est le mécanisme fondamental de la section 1 : la fréquence dans le corpus ne reflète pas le statut épistémique actuel.
Le cinquième mécanisme est le plus fondamental pour les enjeux écologiques : l’absence structurelle de la nature dans les modèles macroéconomiques. Les fonctions de production agrégées standard reposent sur une hypothèse dite de « soutenabilité faible » : le capital artificiel peut indéfiniment se substituer au capital naturel. Ce postulat, formalisé dès 1974 dans une série d’articles fondateurs publiés dans le même numéro spécial de la Review of Economic Studies — Dasgupta et Heal, Solow, Stiglitz35 — rétrospectivement regroupés sous l’appellation « modèle DHSS » » n’est pas une contrainte empirique — c’est un choix théorique aux implications normatives considérables : il rend la croissance indéfiniment possible même en épuisant le capital naturel. Le rapport Dasgupta36 a montré que le PIB, en ignorant la dépréciation des actifs naturels, pousse structurellement vers une croissance non durable. Kate Raworth37 a formalisé l’articulation entre plancher social et plafond écologique. Ces approches restent quasi absentes des manuels de macroéconomie standard et donc des corpus LLM — non parce qu’elles sont réfutées, mais parce qu’elles n’ont pas franchi les barrières institutionnelles de la discipline38 (Grandjean & Cohen, The Other Economy, 2022 ; Grandjean, Sciences et politique, 2026).
Score global : très fort, par cinq mécanismes cumulatifs — résistance paradigmatique des modèles opérationnels, lock-in institutionnel documenté, fermeture épistémique, persistance de résultats réfutés dans les corpus, et invisibilisation structurelle du capital naturel.
L’économie écologique
Le profil est inverse mais tout aussi marqué, et le mécanisme de biais est structurellement différent de celui de la macroéconomie : ce n’est pas un paradigme dominant qui résiste à la réfutation, c’est un programme de recherche sérieux et établi qui est systématiquement invisibilisé.
Le signal de long terme est réel mais difficile à produire dans les formats académiques standard. Les seuils planétaires — tels que formulés par Rockström et al.39 puis révisés par Steffen et al.40 — sont quantitativement contestés dans leurs valeurs précises, et les effets des dépassements sur les dynamiques économiques à 50-100 ans restent incertains. Ce n’est pas une lacune propre à l’économie écologique : c’est la condition générale de toute discipline travaillant sur des systèmes complexes à horizons longs. Par analogie avec la médecine, le signal est lent mais réel, et les essais de long terme — comme les travaux du Stockholm Resilience Centre sur les interactions entre seuils planétaires et systèmes économiques — produisent des résultats progressivement plus robustes.
Le corpus académique existe, est abondant, et est institutionnellement reconnu. La revue Ecological Economics, fondée en 1989 par Robert Costanza41, publie depuis plus de trente ans des travaux rigoureux sur la valeur économique des services écosystémiques, les limites biophysiques de la croissance et les alternatives au PIB. La revue Ecosystem Services (depuis 2012) et le Journal of Political Economy and Ecology couvrent les interfaces entre dynamiques écosystémiques et économie. Les figures fondatrices — Herman Daly42, qui a développé le concept d’économie en état stationnaire, Nicholas Georgescu-Roegen43, dont les travaux sur la thermodynamique et l’économie ont posé les bases de la bioéconomie, Joan Martinez-Alier44, qui a documenté les conflits écologiques distributifs à l’échelle mondiale — constituent un programme de recherche mature, avec des milliers de publications référencées, des sociétés savantes (International Society for Ecological Economics, fondée en 1988), des formations doctorales, et une présence croissante dans les institutions internationales depuis le rapport Dasgupta (2021).
C’est la résistance sociologique qui produit l’essentiel du biais, et elle est documentée. Fourcade et al.45 ont montré que les revues de premier rang de la discipline économique — American Economic Review, Quarterly Journal of Economics, Journal of Political Economy — sont contrôlées par des comités de rédaction issus des mêmes départements néoclassiques que ceux qui dominent la macroéconomie. Ecological Economics, malgré son ancienneté et son sérieux, n’est pas classée dans les revues de référence utilisées pour les évaluations de carrière dans les départements d’économie standard. Les curricula universitaires en économie ignorent quasi systématiquement Daly et Georgescu-Roegen — une enquête de Söderbaum46 sur les manuels d’introduction à l’économie les plus utilisés dans le monde a montré que les limites biophysiques n’y figurent pas comme contrainte structurelle. La croissance économique comme objectif central y est présentée comme une donnée technique, les contraintes biophysiques comme des « externalités » corrigibles à la marge par des instruments de prix — taxe carbone, marchés de permis — sans remise en cause du cadre général.
Un LLM interrogé sur la compatibilité entre croissance et limites planétaires produira quasi systématiquement une réponse centrée sur la croissance verte et le découplage, sans mentionner spontanément que Daly, Georgescu-Roegen ou les travaux de l’ISEE contestent ces conclusions à leurs fondements thermodynamiques. Non parce que ces travaux sont absents des corpus — ils y sont — mais parce que leur poids statistique est sans commune mesure avec celui des publications mainstream, des rapports institutionnels et des manuels qui constituent la masse du corpus d’entraînement.
Score global : très fort, par un mécanisme de biais structurellement opposé à celui de la macroéconomie standard. Là, c’est le paradigme dominant qui résiste à la réfutation ; ici, c’est l’approche critique qui est marginalisée — non par manque de rigueur, mais par asymétrie institutionnelle et statistique dans les corpus.
5.2 Technosciences artefactuelles (catégorie 4)
Le profil de cette catégorie est paradoxal. Le signal de vérité sur les mécanismes immédiats est réel mais limité : il couvre le cœur historique de la catégorie — génie civil classique, mécanique de précision, électronique — mais pas ses développements les plus récents ni les plus controversés. La géo-ingénierie ne peut être testée qu’à petite échelle, alors que ses effets ne se produisent qu’à grande échelle. Les OGM ne permettent pas de conclusions à court terme sur leurs effets écosystémiques par construction. L’agrochimie intensive ne révèle ses effets sur les sols et la biodiversité qu’à 20-30 ans. En revanche, les effets systémiques à long terme sont quasi absents des corpus dominants et des évaluations standard dans l’ensemble de la catégorie. Le paradigme résiste fortement via le lock-in sociotechnique : les choix passés d’infrastructure créent des irréversibilités qui résistent à la réfutation par des alternatives. Et les choix de design encodent des valeurs politiques et sociales majeures présentées comme contraintes techniques. Score global : fort.
Deux exemples illustrent le biais concret. L’assimilation des plantations industrielles de résineux aux forêts naturelles dans les bilans carbone : un LLM interrogé sur ce sujet présentera généralement les plantations comme un outil de séquestration carbone valide, sans signaler le débat scientifique sur la non-équivalence écologique — biodiversité, sols, cycle de l’eau, résilience au feu.
La géo-ingénierie solaire — principalement l’injection de particules soufrées dans la stratosphère pour réduire le rayonnement solaire incident (Stratospheric Aerosol Injection, SAI) — illustre particulièrement bien le biais de la catégorie 4.
Un LLM la présente régulièrement comme une solution technique disponible ou en voie de l’être, sans signaler les trois ensembles de problèmes qui font l’objet d’un débat scientifique et politique sérieux depuis au moins 2008. Sur les risques physiques, Robock47 a formulé vingt objections documentées, dont les plus sérieuses sont les effets régionaux asymétriques : une réduction du rayonnement solaire mondial affecterait différemment les régimes de précipitations selon les régions, avec des risques de sécheresse documentés en Afrique et en Asie. S’y ajoute le risque de termination shock48 : si le déploiement était interrompu brutalement — pour des raisons politiques, économiques ou militaires — le réchauffement accumulé masqué se produirait en quelques années, à une vitesse sans précédent. Des travaux récents ont également montré que la géo-ingénierie solaire pourrait redistribuer les risques de paludisme49 entre pays en développement.
Sur la gouvernance, la situation est celle d’un vide structurel et d’un désaccord profond. Il n’existe aucun accord international gouvernant exclusivement la recherche ou le déploiement de la géo-ingénierie solaire. En 2019, une tentative d’obtenir un accord international sur un cadre de gouvernance a échoué en raison de l’opposition des États-Unis et de l’Arabie saoudite. À la sixième Assemblée des Nations Unies pour l’environnement (UNEA-6) en février 2024 à Nairobi, une résolution sur la géo-ingénierie solaire (UNEP/EA.6/L.18) a été discutée mais n’a pas abouti50, les pays africains et plusieurs pays du Sud global ayant appelé à un mécanisme de non-utilisation, tandis que d’autres blocs défendaient la poursuite de la recherche. Plus de 400 scientifiques ont signé en 2022 une lettre ouverte51 appelant à un accord international de non-utilisation, estimant que les organes des Nations Unies sont incapables de garantir un contrôle multilatéral équitable et efficace sur le déploiement de ces technologies à l’échelle planétaire.
Sur l’aléa moral, enfin, la mise en avant de la géo-ingénierie comme solution disponible risque de réduire la pression politique pour la réduction des émissions — ce que Robock et d’autres ont désigné sous le terme de moral hazard. Ce risque est documenté dans la littérature depuis 2008 mais structurellement absent des présentations optimistes de la technologie.
Un LLM présente la géo-ingénierie solaire comme une option technique sérieuse sans signaler spontanément aucun de ces trois ensembles de problèmes — non parce que la littérature n’existe pas, mais parce que les publications enthousiastes sur la faisabilité technique sont statistiquement plus nombreuses dans les corpus que les publications critiques sur les risques et la gouvernance.
5.3 Solutions fondées sur la nature (catégorie 5)
Cette catégorie subit une double pénalité, de nature différente de celle de la catégorie 4. Le signal de vérité à long terme est difficile à produire, mais pas absent : des essais de longue durée existent — Rodale Institute depuis 198152, essais INRAE de longue durée, notamment l’essai sans pesticides sur onze ans dans le Bassin parisien53, une revue de synthèse récente54 ainsi qu’une modélisation à l’échelle mondiale55 montrent que les écarts de rendement avec l’agriculture conventionnelle dépendent fortement des contextes et des pratiques. Par analogie avec la médecine — discipline où les essais cliniques de long terme sont lents mais méthodologiquement établis — on peut défendre un signal de vérité de long terme modéré plutôt que quasi nul.
La pénalité principale vient d’ailleurs : c’est la marginalisation paradigmatique. Le corpus académique sur l’agroécologie dépassait 12 000 publications référencées en 2019, tous sujets confondus, dans les principales bases de données scientifiques56. Les publications croisant agroécologie et politiques publiques ont pour leur part connu une croissance de 60% entre 2020 et 202357 — signe d’une légitimation institutionnelle accélérée. Mais cette production est noyée dans des décennies de littérature agrochimique et de rapports d’institutions structurellement favorables à l’agriculture intensive. Des outils d’évaluation multidimensionnelle comme OASIS58, appliqués à des fermes biologiques et conventionnelles en Europe, montrent que la performance agroécologique ne se réduit pas au rendement : elle intègre la résilience, la biodiversité, la viabilité économique et les dimensions socio-politiques. C’est précisément cette multidimensionnalité que le critère implicite du LLM invisibilise. Et même sur le seul critère du rendement, la réponse sceptique présentée comme équilibrée passe sous silence que les écarts avec l’agriculture conventionnelle dépendent fortement des contextes et se réduisent avec l’amélioration des pratiques.
Score global : fort — avec le mécanisme de biais le plus pernicieux de l’ensemble : l’invisibilisation d’un corpus en cours de légitimation scientifique accélérée, présenté comme une niche alors qu’il représente un programme de recherche mature et croissant. Ce que le modèle présente comme un biais militant est en réalité une intégration épistémique des dimensions normatives — les valeurs y sont constitutives, pas accidentelles.
6. Implications méthodologiques et institutionnelles
L’analyse précédente a établi que le biais paradigmatique des grands modèles de langage n’est pas un défaut ponctuel, corrigible par un meilleur prompt ou un déploiement plus prudent, mais une propriété structurelle découlant du mécanisme même d’apprentissage statistique — aggravée par la sycophancy induite par l’alignement, par la surreprésentation linguistique anglophone des corpus, par la contamination croissante par les revues prédatrices et par une boucle de rétroaction épistémique (les productions des LLM étant reprise dans les futures données d’entraînement, contribuent à stabiliser les cadres interprétatifs qu’ils avaient d’abord seulement reproduits) . Ce biais suit un gradient précis : très faible dans les usages vérifiables des disciplines dotées d’un signal de vérité externe fort (mathématiques, sciences formelles), il croît à mesure que ce signal s’affaiblit, atteint son maximum dans les sciences sociales et humaines, et prend une forme spécifique — le solutionnisme technologique — dans les technosciences artefactuelles, où le critère de performance à court terme occulte les effets systémiques de long terme. Les solutions fondées sur la nature subissent une double pénalité : leurs bénéfices, diffus et de long terme, sont structurellement sous-évalués par ce même critère implicite de performance immédiate, alors même que leur corpus académique est mature et en croissance rapide.
L’analyse par système — prompt, RAG, agents, modèles de raisonnement — montre que l’architecture peut atténuer ou amplifier ce biais selon qu’elle organise ou non la pluralité des sources, mais qu’aucune de ces couches ne le supprime : le prompt déplace la correction vers la compétence de l’utilisateur, le RAG vers la gouvernance documentaire, les modèles de raisonnement restent bornés par le même gradient de signal de vérité. Le paradoxe central que souligne cet article est que les disciplines les plus utiles à la compréhension et à la conduite de la transition écologique — économie écologique, agroécologie, sciences du système Terre — sont précisément celles où ce biais est le plus fort. Cette situation appelle des réponses à quatre niveaux : la vigilance critique de l’utilisateur non expert, l’audit des biais paradigmatiques par la recherche en IA, la transparence des arbitrages dans la gouvernance des modèles, et une architecture documentaire — le RAG épistémiquement augmenté — capable de qualifier les sources par leur position paradigmatique plutôt que par leur seule pertinence statistique.
Précisons pour éviter toute ambiguïté que souligner les biais paradigmatiques des LLM ne conduit pas au relativisme —l’impasse symétrique du relativisme que Jacques Bouveresse59 et Georges Orwell60 ont analysée avec précision : si les énoncés scientifiques ne sont que des constructions parmi d’autres, le pouvoir appartient à ceux qui ont la meilleure rhétorique — ce qui est précisément l’inverse de ce que la critique des biais paradigmatiques cherche à défendre. Dire que les modèles sous-représentent l’économie écologique ou sont sur-confiants dans les DSGE ne signifie pas que tout se vaut épistémiquement. Cela signifie précisément l’inverse : qu’il existe des degrés de robustesse empirique, des faits acquis et intangibles d’un côté, des paradigmes contestables de l’autre, et que les LLM effacent cette distinction en traitant les deux avec la même assurance.
L’ analyse faite dans les chapitres précédents a des implications à plusieurs niveaux.
Pour l’utilisateur non-expert
C’est à ce niveau que les enjeux sont les plus immédiats, et les moins visibles. Le spécialiste sait où chercher ce qui manque dans une réponse ; il dialogue avec le modèle à armes égales. L’étudiant, le décideur, le journaliste ou le citoyen éclairé qui interroge un LLM sur l’intérêt d’un taux d’intérêt vert, les promesses de l’agroécologie ou les risques de la géo-ingénierie ne dispose pas de cette ressource — et c’est précisément pour cela qu’il s’adresse au modèle. La grille proposée dans cet article est d’abord un outil pour lui : elle permet d’anticiper, catégorie par catégorie, où la vigilance critique doit être maximale (catégories 3, 4 et 5), de comprendre qu’une réponse assurée n’est pas une réponse vérifiée — la surconfiance étant, on l’a vu, structurellement la plus forte là où elle est la moins justifiée —, et de retenir que l’approche la plus absente d’une première réponse est souvent celle dont il aurait le plus besoin. Plus précisément l’utilisateur non-expert peut “pousser le LLM dans ses retranchements” en lui demandant explicitement (essentiellement pour les catégories 3, 4 et 5) :
- de comparer explicitement la réponse du paradigme dominant et celle d’une approche critique sérieuse et en précisant ce qui manque dans la première réponse et quelles références auraient dû apparaître.
- de séparer faits robustes, hypothèses contestées et choix de valeurs.
- de rechercher des sources non anglophones ou issues de traditions minoritaires lorsque le sujet s’y prête.
Pour la recherche en IA
La grille proposée fournit un cadre pour auditer les biais paradigmatiques des modèles, en complément des audits de biais démographiques déjà développés. L’AI Act européen prévoit des obligations d’audit pour les modèles à usage général. Les étendre aux biais de conformité intellectuelle — surreprésentation des approches découplées des contraintes physiques, minoration des sciences du système Terre et des approches interdisciplinaires — est techniquement faisable : il s’agit de soumettre les modèles à des batteries de questions contrastées, conçues pour révéler si deux approches épistémiquement comparables reçoivent un traitement symétrique, et de mesurer les écarts systématiques de formulation, de confiance exprimée et de complétude.
Pour la gouvernance des modèles
Les développements récents du RLAIF et du Constitutional AI déplacent une partie du biais humain vers les principes encodés dans les modèles de préférence. Cette évolution appelle trois exigences de transparence que ni le cadre réglementaire actuel ni les pratiques volontaires des labs ne satisfont pleinement. Premièrement, la publication des principes directeurs ne suffit pas : les arbitrages effectivement réalisés dans les cas limites — quelle controverse a été qualifiée de « marginale », quel consensus a été jugé « établi » — doivent être documentés et accessibles à l’audit.
Deuxièmement, les modèles de préférence eux-mêmes doivent être auditables : puisqu’ils encodent des jugements de qualité épistémique, ils sont soumis aux mêmes biais paradigmatiques que les modèles qu’ils évaluent, et les méthodes de probing par questions contrastées décrites plus haut leur sont directement applicables.
Troisièmement, la composition disciplinaire des panels d’évaluateurs experts est une question de gouvernance scientifique : un panel dominé par des ingénieurs et des économistes mainstream produira un modèle de préférence structurellement différent d’un panel incluant des écologues, des économistes hétérodoxes et des chercheurs du Sud global. Cette dimension — qui sont les humains qui, in fine, définissent ce qu’est une « bonne réponse » — est aujourd’hui largement opaque. La rendre transparente et pluraliste est une condition nécessaire, sinon suffisante, pour que les grands modèles de langage cessent de reproduire les biais paradigmatiques que cet article s’est attaché à cartographier.
Quatrièmement, à côté des model cards61 et des datasheets62 classiques, il faudrait développer des paradigm cards ou epistemic datasheets : des fiches documentant, pour un corpus ou un système RAG, les traditions intellectuelles représentées, les écoles marginalisées, les langues couvertes, les controverses actives, le statut des sources et les arbitrages de sélection. Ce n’est pas une couche de conformité supplémentaire ; c’est une documentation de la pluralité épistémique.
Ces exigences de transparence s’inscrivent dans un cadre plus large de souveraineté épistémique dont la dimension géopolitique est encore insuffisamment prise en compte. Badré et Voisin63 posent la question de façon directe dans le contexte de la finance durable : à quoi bon construire des infrastructures cloud souveraines et des modèles d’IA européens si la matière première — les données qui les alimentent — reste hors de portée juridique et politique de l’Union ? Le paradoxe européen est ici frappant : jamais l’Union n’a produit autant de données de durabilité — reporting CSRD, taxonomie verte, scénarios climatiques — mais toute la chaîne de valeur de leur traitement et de leur interprétation dépend d’entités qui lui échappent. L’AI Act européen, aussi ambitieux soit-il sur le plan normatif, ne résout pas ce problème : il encadre les usages sans adresser la question de la provenance et de la gouvernance des données d’entraînement. Une véritable souveraineté épistémique suppose trois conditions complémentaires : des bases de données documentaires qualifiées selon leurs métadonnées paradigmatiques — c’est l’objet du RAG épistémiquement augmenté proposé plus ci-après — ; des modèles d’IA entraînés sur des corpus incluant les traditions intellectuelles non anglophones et les approches critiques des paradigmes dominants ; et une gouvernance des données d’entraînement soumise à des obligations de transparence et d’audit indépendant. Ce n’est pas une question technique. C’est, comme le formulent Badré et Voisin, une question de protection des valeurs fondamentales — en l’occurrence, la capacité des sociétés démocratiques à définir elles-mêmes les cadres analytiques qui orientent leurs choix collectifs.
Pour l’architecture des systèmes d’information scientifique
Une voie corrective pragmatique, à l’échelle des systèmes d’information scientifique, consiste à développer des systèmes RAG — Retrieval-Augmented Generation : des architectures qui augmentent la génération du modèle en récupérant dynamiquement des documents externes au moment de la requête, plutôt qu’en s’appuyant uniquement sur ce qui a été mémorisé lors de l’entraînement — enrichis de métadonnées épistémiques. Cette approche ne répond pas aux critiques fondamentales64 adressées aux LLM et, plus largement, au deep learning statistique : absence de modèle explicite du monde, faiblesse du raisonnement causal, généralisation hors distribution fragile, difficulté à planifier et à raisonner de manière robuste. Elle vise plus modestement à rendre l’accès aux sources plus contrôlable, pluraliste et auditable. C’est une piste que nous désignons ici comme « RAG épistémiquement augmenté », en l’absence d’équivalent établi dans la littérature. Des travaux récents65 suggèrent que le RAG peut améliorer la diversité épistémique des LLM, mais sans qualifier les sources par leur position paradigmatique. L’extension proposée consiste à annoter chaque source non seulement par son contenu mais par ses métadonnées paradigmatiques : école de pensée, degré de consensus réel dans la communauté concernée, controverses actives, position dans le débat. Un tel système peut restituer, pour une même question, les réponses du paradigme dominant et celles des approches critiques sérieuses, avec leur statut respectif. Les conditions institutionnelles et techniques d’un tel projet à l’échelle européenne feront l’objet d’un document séparé.
- Pour une introduction à ces modèles, voir cet article de Zysla Belliat & Mathieu Morgensztern, L’IA générative : une histoire de mathématiques – Voyage au cœur des équations qui font parler les machines, Variances (08/05/2026). ↩︎
- Ouyang et al., 2022, Training language models to follow instructions with human feedback. Ce papier fondateur montre que le comportement final dépend fortement du post-entraînement humain. ↩︎
- Chen et al. (2021), Evaluating Large Language Models Trained on Code, OpenAI. HumanEval consiste en 164 problèmes de programmation Python avec tests unitaires automatisés. ↩︎
- Koohestani et al. (2025), HumanEvalNext ; Bradbury et al. (2024), HumanEval-T. Les variantes non contaminées montrent des chutes de 20 à 31 points de pourcentage par rapport aux scores affichés sur HumanEval standard. ↩︎
- Jimenez et al. (2024), SWE-bench : Can Language Models Resolve Real-world Github Issues?, ICLR 2024. SWE-bench Verified est une version validée par des annotateurs humains publiée par OpenAI en août 2024 (Chowdhury et al., 2024), contenant 500 problèmes réels de développement logiciel. ↩︎
- Aleithan et al. (2024), SWE-bench+ : Enhanced Coding Benchmark for LLMs. Le taux de résolution sur SWE-bench complet est passé de 0,17% (RAG+GPT-3.5) à environ 22% pour les meilleurs systèmes en 2024, et jusqu’à 45% sur les variantes simplifiées. ↩︎
- Voir Open Science Collaboration (2015). Estimating the reproducibility of psychological science. Science, 349, aac4716. Many Labs 1: Klein, R.A., Ratliff, K.A., Vianello, M., Adams, R.B. Jr. et al. & Nosek, B.A. (2014). Investigating variation in replicability: A « Many Labs » replication project. Social Psychology, 45(3), 142–152 et Many Labs 2: Klein, R.A., Vianello, M., Hasselman, F., Adams, B.G. et al. (2018). Many Labs 2: Investigating variation in replicability across samples and settings. Advances in Methods and Practices in Psychological Science, 1(4), 443–490. ↩︎
- Imre Lakatos, philosophe des sciences hongrois (1922-1974), a développé dans The Methodology of Scientific Research Programmes (1978) une théorie de l’évolution scientifique plus nuancée que celle de Popper. Pour Lakatos, la science ne progresse pas par réfutation directe des théories (comme le formulait Karl Popper), mais par la compétition entre programmes de recherche — des ensembles structurés d’hypothèses entourant un « noyau dur » que les chercheurs s’engagent à ne pas remettre en cause. Autour de ce noyau, une « ceinture protectrice » d’hypothèses auxiliaires absorbe les anomalies empiriques sans que le noyau soit touché. Un programme est dit progressif quand il génère des prédictions nouvelles qui se vérifient — il étend notre connaissance. Il est dit dégénératif quand il ne fait plus que s’adapter après coup aux anomalies, sans rien prédire de nouveau — il survit institutionnellement sans produire de connaissance. Appliqué aux modèles DSGE, l’argument est le suivant : après 2008, le paradigme n’a pas été réfuté ni révisé en profondeur, mais ses défenseurs ont ajouté des « frictions financières » pour accommoder les faits nouveaux — un ajustement ad hoc typique d’un programme dégénératif. Stiglitz (2018) et Storm (2021) ont explicitement mobilisé ce cadre lakatosien pour caractériser l’état de la macroéconomie mainstream. ↩︎
- Stiglitz, J. (2018), Where modern macroeconomics went wrong, Oxford Review of Economic Policy, 34(1-2), 70-106. ↩︎
- Voir Emmanuel Carré. 2026, Pourquoi l’IA vous dit toujours que vous avez une excellente idée, ou l’effet sycophante, The Conversation. ↩︎
- Sharma, M. et al. (2023). Towards understanding sycophancy in language models. ↩︎
- Leng, J., Huang, C., Zhu, B. & Huang, J. (2024), Taming overconfidence in LLMs: Reward calibration in RLHF. Groot, T. & Valdenegro-Toro, M. (2024), Overconfidence is key: Verbalized uncertainty evaluation in large language and vision-language models. Proceedings of the 4th Workshop on Trustworthy Natural Language Processing (TrustNLP 2024), pp. 145–171. Association for Computational Linguistics. Leng et al démontrent que le RLHF conduit les modèles à exprimer une surconfiance verbalisée dans leurs propres réponses, et que les modèles de récompense utilisés dans l’algorithme d’optimisation par renforcement le plus couramment utilisé en RLHF présentent des biais inhérents en faveur des scores de haute confiance, indépendamment de la qualité réelle des réponses.. Groot & Valdenegro-Toro (2024) ciblent spécifiquement l’incertitude verbalisée — ce que le modèle dit explicitement sur sa propre certitude (« je suis certain que… », « il est établi que… ») — et montrent qu’elle est systématiquement surestimée. C’est le versant linguistique du même phénomène. ↩︎
- Bai et al. (2022). Constitutional AI: Harmlessness from AI feedback. L’article est signé par 52 auteurs, tous d’Anthropic sauf Azalia Mirhoseini (Stanford). C’est la référence canonique pour le Constitutional AI et le RLAIF. Il existe également une version mise à jour de la constitution publiée par Anthropic en janvier 2026, disponible sur Anthropic (2026). Claude’s Constitution — January 2026. À noter que la constitution de 2026 est certes publique, mais les arbitrages effectivement réalisés dans les cas limites, eux, ne le sont pas. ↩︎
- Nature News (novembre 2025) — « Large language models are biased — local initiatives are fighting for change » et Wright, D., Masud, S., Moore, J., Yadav, S., Antoniak, M., Christensen, P.E., Park, C.Y. & Augenstein, I. (2025). Epistemic diversity and knowledge collapse in large language models. ↩︎
- Voir Wright op. cit. ↩︎
- La souveraineté des données, l’angle mort de la finance durable, La revue Banque. 2026. ↩︎
- Shumailov et al., 2024, AI models collapse when trained on recursively generated data, Nature.
Montre que les contenus générés peuvent appauvrir les distributions futures.
Liang et al., 2024, Mapping the Increasing Use of LLMs in Scientific Papers. Montre que les LLM entrent déjà dans la production scientifique elle-même.
Kleinberg & Raghavan, 2021, Algorithmic monoculture and social welfare.
Pas spécifique aux LLM, mais excellent pour penser le risque d’un même système utilisé partout, produisant les mêmes angles morts. ↩︎ - Wei et al. (2022), Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. Source pivot pour mentionner les raisonnements intermédiaires sans leur attribuer une correction automatique des biais. ↩︎
- Wang, X., Wei, J., Schuurmans, D., Le, Q., Chi, E., Narang, S., Chowdhery, A., & Zhou, D. (2022/2023), Self-Consistency Improves Chain of Thought Reasoning in Language Models. Présenté à l’International Conference on Learning Representations (ICLR 2023). ↩︎
- Lewis, P. et al. (2020), Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks, Advances in Neural Information Processing Systems 33 (NeurIPS 2020), p. 9459-9474. ↩︎
- Yao, S., Zhao, J., Yu, D., Du, N., Shafran, I., Narasimhan, K., & Cao, Y. (2022/2023), ReAct: Synergizing Reasoning and Acting in Language Models. Présenté à l’International Conference on Learning Representations (ICLR 2023). ↩︎
- Greshake et al. (2023), Not what you’ve signed up for. Source pivot sur l’indirect prompt injection dans les applications LLM connectées à des documents ou outils. ↩︎
- Voir Hendrycks et al., 2020, Measuring Massive Multitask Language Understanding. Srivastava et al., 2022/2023, Beyond the Imitation Game: Quantifying and extrapolating the capabilities of language models. Liang et al., 2022/2023, Holistic Evaluation of Language Models, et Bommasani, R., Liang, P., & Lee, T. (2023), Holistic Evaluation of Language Models. Annals of the NY Academy of Sciences. Kiela et al., 2021, Dynabench: Rethinking Benchmarking in NLP. Raji et al., 2021, AI and the Everything in the Whole Wide World
Benchmark. ↩︎ - Mirzadeh et al., 2024, GSM-Symbolic: Understanding the Limitations of Mathematical Reasoning in Large Language Models. Montre que les performances chutent quand on modifie des nombres ou ajoute une clause inutile. Azerbayev et al., 2023, ProofNet: Autoformalizing and Formally Proving Undergraduate-Level Mathematics. Montre l’écart entre énoncé/preuve en langage naturel et preuve formelle vérifiable en Lean. Yang et al., 2023, Lean Dojo: Theorem Proving with Retrieval-Augmented Language Models. Source sur l’usage de Lean et du RAG pour vérifier les preuves. Utile pour dire que la vérification formelle reste nécessaire. Le papier montre aussi que l’accès à une bibliothèque formelle améliore les performances, ce qui confirme que le modèle seul ne suffit pas toujours. ↩︎
- Kuhn, T.S. (1962), The Structure of Scientific Revolutions, University of Chicago Press. ↩︎
- Science de la science et réflexivité. Cours du Collège de France, 2001. ↩︎
- Romer, P. (2016), The trouble with macroeconomics, The American Economist, NBER Working Paper. ↩︎
- Voir sur ces questions : Jacobs & Wallach, 2021, Measurement and Fairness. Raji et al., 2021, AI and the Everything in the Whole Wide World Benchmark. ↩︎
- Open Science Collaboration (2015). Estimating the reproducibility of psychological science. Science, 349, aac4716. ↩︎
- Storm, S. (2021), Cordon of conformity: Why DSGE models are not the future of macroeconomics, International Journal of Political Economy, 50(2). ↩︎
- Fourcade, M., Ollion, E. & Algan, Y. (2015), The superiority of economists, Journal of Economic Perspectives, 29(1), 89–114. ↩︎
- Coriat, B. et al. (2017), Misère du scientisme en économie, Les Liens qui Libèrent. ↩︎
- Reinhart, C. & Rogoff, K. (2010), Growth in a time of debt, American Economic Review, 100(2), 573–578. ↩︎
- Herndon, T., Ash, M. & Pollin, R. (2014), Does high public debt consistently stifle economic growth? A critique of Reinhart and Rogoff, Cambridge Journal of Economics, 38(2), 257–279. ↩︎
- Dasgupta, P., & Heal, G. M. (1974), Optimal Depletion of Exhaustible Resources, The Review of Economic Studies, 41 (Symposium), 3–28. Solow, R. M. (1974), Intergenerational Equity and Exhaustible Resources, The Review of Economic Studies, 41 (Symposium), 29–45. Stiglitz, J. E. (1974), Growth with Exhaustible Natural Resources: Efficient and Optimal Growth Paths, The Review of Economic Studies, 41 (Symposium), 123–137. ↩︎
- Dasgupta, P. (2021), The Economics of Biodiversity: The Dasgupta Review, London: HM Treasury. ISBN 978-1-911680-29-1. ↩︎
- Raworth, K. (2017), Doughnut Economics: Seven Ways to Think Like a 21st-Century Economist, London: Random House Business / Chelsea Green Publishing. ↩︎
- Voir la plateforme The other economy. ↩︎
- Rockström, J. et al. (2009), A safe operating space for humanity, Nature, 461, 472–475. ↩︎
- Steffen, W. et al. (2015), Planetary boundaries: Guiding human development on a changing planet, Science, 347, 1259855. ↩︎
- Costanza, R. et al. (1997), The value of the world’s ecosystem services and natural capital, Nature, 387, 253–260. ↩︎
- Daly, H.E. (1996), Beyond Growth: The Economics of Sustainable Development, Beacon Press. ↩︎
- Georgescu-Roegen, N. (1971), The Entropy Law and the Economic Process, Harvard University Press. ↩︎
- Martinez-Alier, J. (2002), The Environmentalism of the Poor, Edward Elgar. ↩︎
- op. cit. ↩︎
- Söderbaum, P. (2008), Understanding Sustainability Economics, Earthscan. ↩︎
- Robock, A. (2008), 20 reasons why geoengineering may be a bad idea, Bulletin of the Atomic Scientists, 64(2), 14–18. ↩︎
- Trisos, C.H., Amatulli, G., Gurevitch, J., Robock, A., Xia, L. & Zambri, B. (2018), Potentially dangerous consequences for biodiversity of solar geoengineering implementation and termination, Nature Ecology & Evolution, 2, 475–482. ↩︎
- Carlson, C.J., Colwell, R., Robock, A. et al. (2022), Solar geoengineering could redistribute malaria risk in developing countries, Nature Communications, 13, 2150. ↩︎
- Biermann, F. et al. (2022), Solar geoengineering: The case for an international non-use agreement, WIREs Climate Change, 13(3), e754 ↩︎
- Voir le site Solar Geoengineering Non-Use Agreement. ↩︎
- Seidel, R., Moyer, J., Nichols, K. et al. (2015). Organic Agriculture, Springer. ↩︎
- Deytieux et al., The farming system component of European agricultural landscapes, European Journal of Agronomy, 2012 ↩︎
- Seufert & Ramankutty, Many shades of gray-The context-dependent performance of organic agriculture, Science Advances, 2017 ↩︎
- Barbieri et al., Global option space for organic agriculture is delimited by nitrogen availability, Nature Food, 2021; il s’agit d’une modélisation de l’espace d’option pour l’agriculture biologique délimité par l’azote disponible, pas une méta-analyse de rendements. ↩︎
- Goëtte, L., Bezner Kerr, R. et al. (2023). Identifying social science engagement within agroecology: Classifying transdisciplinary literature with a semi-automated textual classification method. PLOS ONE / Frontiers in Sustainable Food Systems. ↩︎
- Gervazio et al., Agroecology and public policies in global scientific literature: a bibliometric analysis, Discover Sustainability, 2025 ↩︎
- Wezel, A. et al., (2025). Application of the Original Agroecological Survey and Indicator System tool (OASIS) to organic and conventional farms in Belgium, France, and Italy. Frontiers in Agronomy, 7 ↩︎
- Rationalité et cynisme, Editions de Minuit, 1984 ↩︎
- 1984, Payot, 1949. ↩︎
- Les Model cards sont des documents standardisés accompagnant un modèle d’apprentissage automatique publié, décrivant ses caractéristiques techniques, ses cas d’usage prévus et déconseillés, les données d’entraînement, les métriques de performance ventilées par sous-groupes, ainsi que les limites et biais connus. Voir Mitchell et al. (2019), Model Cards for Model Reporting. Source de référence pour la documentation des modèles. ↩︎
- Les Datasheets (for datasets) sont des documents accompagnant un jeu de données et détaillant sa composition, son mode de collecte, son processus de nettoyage et d’annotation, les usages envisagés, ainsi que les considérations éthiques et légales relatives à sa constitution. Concept proposé par Gebru et al. (2021), Datasheets for Datasets. Source de référence pour la documentation des datasets. Bender & Friedman (2018), Data Statements for Natural Language Processing. Source très pertinente pour documenter langue, population, contexte et conditions de production des données. ↩︎
- Op.cit. ↩︎
- Voir notamment Yann LeCun, A Path Towards Autonomous Machine Intelligence, OpenReview, 2022, qui défend la nécessité de modèles du monde, de planification et d’architectures de type JEPA ; et Yoshua Bengio, From System 1 Deep Learning to System 2 Deep Learning, NeurIPS invited talk, 2019, sur la nécessité de dépasser l’apprentissage intuitif/statistique vers des formes de raisonnement, causalité et généralisation plus robustes. ↩︎
- Wright, D., Masud, S., Moore, J., Yadav, S., Antoniak, M., Christensen, P.E., Park, C.Y. & Augenstein, I. (2025). Epistemic diversity and knowledge collapse in large language models. arXiv:2510.04226. À noter que cet article documente non seulement l’impact positif du RAG sur la diversité épistémique, mais aussi le fait que tous les modèles testés sont moins épistémiquement diversifiés qu’une simple recherche web, et que les revendications spécifiques à un pays reflètent davantage la langue anglaise que la langue locale. ↩︎
Laisser un commentaire